I due server vanno giù insieme, nello stesso secondo.
È la cosa che non doveva succedere, perché erano stati messi lì apposta per non farla succedere: due macchine identiche, failover automatico, prove fatte. Se ne rompe una, l’altra prende il lavoro e nessuno se ne accorge. Era stato collaudato, e funzionava.
Solo che nessuno dei due si è rotto. Si è rotto qualcosa che avevano in comune.
Nelle ore successive verrà fuori cos’era. Magari il gruppo di continuità che alimentava entrambi. Magari il certificato scaduto alla stessa ora su tutti e due. Magari l’aggiornamento che, essendo automatico e uguale per tutti, è arrivato su entrambi nello stesso momento. Il dettaglio cambia da azienda ad azienda, il meccanismo è sempre quello.
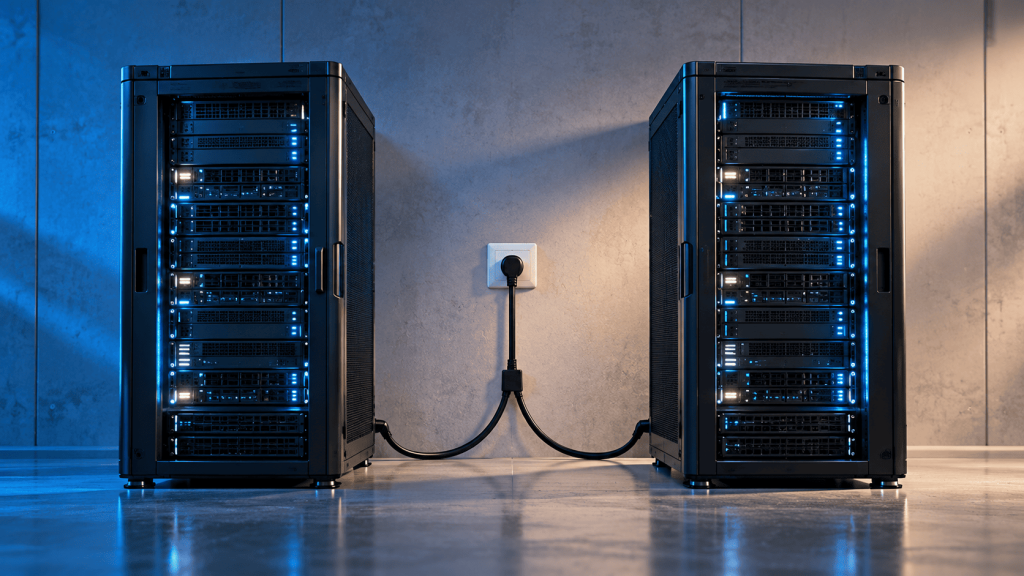
Ed è da qui che vale la pena partire. Avere due copie ti protegge quando se ne rompe una, non quando si rompe qualcosa che usano entrambe. E qualcosa in comune, due server, ce l’hanno sempre: la corrente, la rete, il pannello da cui si gestiscono, gli aggiornamenti che ricevono.
Tre gradini, non due parole
Prima di andare a caccia delle cose in comune, conviene mettere in fila tre termini che nelle riunioni vengono usati come sinonimi, ma che sinonimi non sono. Li presento come una scala, perché ogni gradino comprende quello prima e va un passo più in là.
- Ridondanza: ho più copie.
È una condizione, ed è la più facile da comprare. Due server invece di uno, due alimentatori, due linee. Da sola non promette nulla su come si comporta il servizio quando una delle copie viene a mancare: dice solo che una copia c’è. - Fault tolerance: il servizio continua mentre un pezzo è caduto.
È un comportamento, ed è più esigente. Non basta avere il ricambio, serve che il passaggio avvenga senza che l’utente se ne accorga, e serve soprattutto che le copie non condividano il punto debole. Una ridondanza fatta di due elementi che cadono insieme non produce nessuna tolleranza al guasto: produce due macchine spente invece di una. - Resilienza: il sistema nel suo insieme assorbe il colpo e torna in piedi.
È una proprietà dell’insieme, e comprende anche quello che succede quando le cose vanno peggio del previsto: degradare invece di spegnersi, contenere il danno, ripristinare. Di questo abbiamo scritto per esteso in alta disponibilità e resilienza, dove il tema era come reagisce un sistema quando un componente rallenta invece di rompersi.
Detta in una riga: la ridondanza è una condizione, la fault tolerance un comportamento, la resilienza una proprietà dell’insieme. Quasi tutte le infrastrutture che incontriamo comprano la prima e danno per scontate le altre due.
Qui ci occupiamo del salto tra il primo e il secondo gradino, che è quello dove si perdono più aziende. E il salto ha un solo requisito, sempre lo stesso: le copie devono essere davvero indipendenti.
Le otto cose che le tue copie hanno in comune
Andiamo nel concreto. Questi sono i punti di guasto condivisi che si ritrovano più spesso, e quasi nessuno di loro compare in uno schema di rete.
- La stessa casa.
Due server nello stesso datacenter condividono l’alimentazione, il raffreddamento, la rete e, se le cose si mettono male sul serio, l’edificio. L’incendio al datacenter di Strasburgo di OVHcloud, nel marzo 2021, ha insegnato la versione estrema di questa lezione: chi teneva l’originale e la copia nello stesso luogo li ha persi insieme. - Lo stesso fornitore a monte.
Una sola connettività, un solo servizio DNS, una sola rete di distribuzione dei contenuti. Puoi avere venti macchine ridondate: se il nome del dominio non si risolve più, per i tuoi clienti sei offline come se le macchine fossero spente. - Lo stesso piano di controllo.
L’hypervisor, l’orchestratore, il pannello da cui si gestisce tutto. È il pezzo che nessuno considera perché non eroga il servizio, lo governa. Quando si guasta lui, le macchine “indipendenti” si scoprono figlie dello stesso genitore. - Lo stesso aggiornamento.
Qui la ridondanza lavora contro di te, ed è la parte controintuitiva. Se distribuisci lo stesso aggiornamento a tutti i server nello stesso momento, più copie identiche significa più macchine che ricevono insieme lo stesso guasto. È quello che il mondo ha visto il 19 luglio 2024, quando un aggiornamento difettoso di un software di sicurezza molto diffuso ha messo in blocco milioni di macchine Windows contemporaneamente, con voli fermi e ospedali in difficoltà. Nessuna di quelle organizzazioni aveva un problema di ridondanza: avevano un problema di uniformità. - La stessa configurazione, con lo stesso errore.
La replica è fedele: copia i dati e copia anche gli sbagli. Una cancellazione fatta per errore, o una cifratura da ransomware, si propagano sulle copie sincronizzate in pochi secondi. È il motivo per cui la replica non è un backup, e per cui nella regola del 3-2-1 la copia separata conta più delle altre due. - La stessa scadenza.
Un certificato, una licenza, una chiave che scadono nello stesso istante su tutti i server. È il guasto più banale e uno dei più frequenti: nessun componente si rompe, semplicemente tutti smettono di fidarsi l’uno dell’altro alla stessa ora. - La dipendenza nascosta a valle.
Due application server ridondati che parlano allo stesso database, allo stesso storage condiviso o allo stesso bilanciatore singolo. La ridondanza si ferma dove comincia il primo pezzo unico, e quel pezzo è quasi sempre più in basso di dove si guarda. - Una sola persona.
L’unico tecnico che sa davvero come si riavvia tutto nell’ordine giusto, e quel giorno è in ferie o ha cambiato lavoro tre mesi fa. Non è un guasto informatico, ma si comporta esattamente come tale.
Il filo che tiene insieme tutti e otto questi punti è uno solo: non “quante copie ho”, ma “che cosa hanno in comune le mie copie”.
Il novembre di Ruote Piemontesi
Facciamo un esempio con un’azienda inventata.
Ruote Piemontesi è un negozio di biciclette che negli anni ha costruito un e-commerce serio: nel periodo tra il venerdì nero e Natale fa una fetta consistente del fatturato annuo.
Prima versione.
L’infrastruttura è ridondata come si deve: due server applicativi dietro un bilanciatore, failover provato, backup notturni. I due server, però, stanno nello stesso datacenter, parlano allo stesso database e appoggiano le immagini dei prodotti sullo stesso storage condiviso. Gli aggiornamenti automatici sono attivi su entrambi, alla stessa ora, e i certificati sono stati installati lo stesso giorno con la stessa scadenza.
L’ultimo venerdì di novembre, mentre il traffico è al massimo dell’anno, lo storage condiviso comincia a dare errori. I due server applicativi sono perfettamente accesi e perfettamente inutili: nessuna pagina prodotto si carica. Il monitoraggio segnala i server in salute, perché lo sono. Il negozio resta fermo quattro ore, nel giorno più importante della stagione, e nessuno riesce a spiegare al titolare come mai “avevamo due server” non sia servito a niente.
Seconda versione.
Stessa azienda, stesso budget nell’ordine di grandezza, scelte diverse fatte in fase di progetto. I due server stanno in due datacenter diversi. Il database ha una copia aggiornata in un altro datacenter, pronta a subentrare con una procedura già provata: è il principio del disaster recovery. Le immagini sono servite anche da una copia distribuita, così un problema di storage rallenta ma non spegne. Gli aggiornamenti si applicano prima a un server e, se dopo un’ora non è successo niente, all’altro. I certificati sono scaglionati e c’è un promemoria che scatta un mese prima.
Stesso guasto sullo storage, stesso venerdì. Le pagine prodotto si caricano un po’ più lente per venti minuti, il tempo di far intervenire la copia distribuita, e gli ordini continuano ad arrivare. Il titolare non se ne accorge, e questa è la parte migliore del lavoro fatto bene: quando funziona, non lo vede nessuno.
La differenza tra le due versioni non è la quantità di ridondanza. È che nella seconda qualcuno si è seduto e ha chiesto, pezzo per pezzo: se questo sparisce adesso, quante delle nostre copie se ne vanno con lui?
Le tre parole in una tabella
| Ridondanza | Fault tolerance | Resilienza | |
|---|---|---|---|
| Che cos’è | Una condizione: ho più copie | Un comportamento: il servizio continua mentre un pezzo è caduto | Una proprietà dell’insieme: assorbo il colpo e torno in piedi |
| Domanda a cui risponde | “Ho un ricambio?” | “L’utente se ne accorge?” | “E se va peggio del previsto?” |
| Cosa richiede | Comprare due volte | Copie davvero indipendenti | Progettare il degrado e il ripristino |
| Da cosa ti protegge | Dal guasto di un singolo pezzo | Dal guasto di un pezzo, senza interruzione | Dalla propagazione e dall’imprevisto |
| Da cosa non ti protegge | Da tutto ciò che le copie condividono | Da un guasto che colpisce tutte le copie insieme | Da niente, ma ha un costo di progettazione |
Come si trova quello che le copie hanno in comune
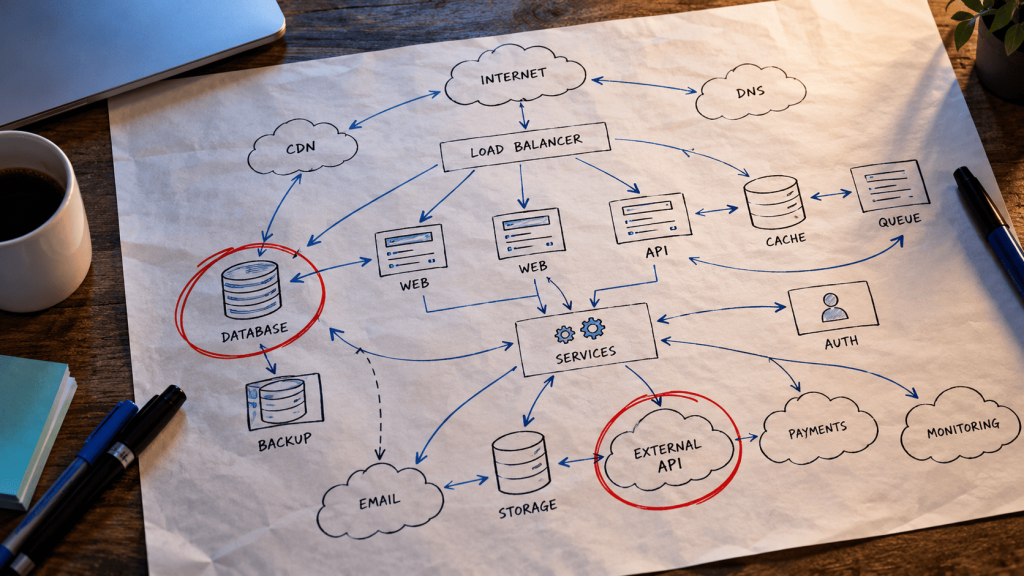
È un lavoro da mezza giornata, e non serve nessuno strumento particolare. Serve un foglio grande e la voglia di essere pignoli.
Si disegna la mappa di quello che serve al servizio per funzionare, scendendo fino ai livelli che di solito si danno per scontati: applicazione, database, storage, rete interna, connettività, DNS, alimentazione, datacenter, fornitore, piano di gestione, chi ci mette le mani. Poi, per ogni elemento della mappa, si fa una domanda sola: se questo sparisce adesso, quante delle mie copie se ne vanno con lui?
Ogni volta che la risposta è “tutte”, hai trovato un punto di guasto condiviso. Non significa che vada eliminato: alcuni costano troppo per il valore che proteggi, e va benissimo tenerseli. Significa che da quel momento è una scelta consapevole, e non una sorpresa che ti aspetta al varco nel giorno peggiore.
Le tre domande da portare al prossimo confronto tecnico:
- Le nostre copie stanno nello stesso posto, sotto lo stesso fornitore o sotto lo stesso pannello di gestione?
- Gli aggiornamenti arrivano a tutti i server nello stesso momento?
- C’è un solo elemento, in fondo alla catena, che se cade porta giù tutto il resto?
Quanto costa, e cosa si compra
Rendere le copie indipendenti ha un costo: un secondo datacenter dove tenere l’altra copia, aggiornamenti scaglionati che allungano le finestre di manutenzione, un po’ di complessità in più da documentare.
Il confronto, però, va fatto con l’unica alternativa, che non è “non spendere”: è pagare la stessa cifra sotto forma di fermo, in un giorno che sceglie il guasto e non tu. Quattro ore di e-commerce spento nel venerdì più importante dell’anno costano più di una copia in un secondo datacenter per dodici mesi, e questo è il conto facile. Quello difficile è il cliente che nel frattempo ha comprato altrove e ha scoperto che si stava benissimo anche lì.
C’è anche una parte che non si compra affatto, ed è quella che rende meglio: scaglionare gli aggiornamenti, scadenzare i certificati in giorni diversi, scrivere la mappa delle dipendenze e farla leggere a più di una persona non costa un euro di infrastruttura. Costa attenzione, una volta, e poi disciplina.
Il punto, in breve
La ridondanza risponde a “quante copie ho”. La domanda che decide se resti in piedi è un’altra: cosa hanno in comune le mie copie.
In sintesi:
- Ridondanza, fault tolerance e resilienza sono tre gradini diversi. Comprare il primo non regala gli altri due.
- Le copie identiche condividono anche i guasti. Stesso posto, stesso fornitore, stesso pannello, stesso aggiornamento, stessa scadenza: sono i modi più comuni per andare giù tutti insieme.
- La replica copia anche gli errori. Cancellazioni e cifrature si propagano alla velocità della sincronizzazione, e per questo serve una copia separata.
- La mappa delle dipendenze costa mezza giornata. Quasi sempre restituisce almeno una sorpresa, ed è meglio trovarla su un foglio che in produzione.
Quindi la domanda da farsi non è se la tua infrastruttura è ridondata. È cosa succede quando cade la cosa che tutte le tue copie hanno in comune, e se qualcuno, in azienda, sa già dire quale sia.
In Cloudable progettiamo infrastrutture partendo da lì: dove sono i punti condivisi, quali conviene eliminare e quali si possono tenere sapendo cosa si rischia. Se vuoi, la mappa della tua la guardiamo insieme: mandaci lo schema che hai, anche fatto a mano e incompleto, e ti diciamo quali punti in comune non avevi segnato.